Gestão de Incidentes de TI: Como Reduzir o MTTR
Gestão de Incidentes de TI: Como Reduzir o MTTR
Gestão de incidentes de TI é o processo que classifica, escala e resolve qualquer interrupção no parque de notebooks ou nos sistemas da empresa, com meta de tempo definida para cada nível de gravidade. Sem esse processo, todo chamado compete pela mesma fila, e o incidente que paralisa a operação demora o mesmo tempo para ser atendido que uma dúvida de uso.
O que é gestão de incidentes de TI (e o que não é)
Gestão de incidentes de TI não é o mesmo que o sistema de chamados de TI. O sistema de chamados é a ferramenta que registra e organiza o ticket; a gestão de incidentes é o processo que decide, a partir desse ticket, qual a gravidade real do problema e quanto tempo a empresa tem até que o impacto fique inaceitável. Também não se confunde com a gestão de mudanças em TI: mudança é uma alteração planejada no ambiente, incidente é algo que já quebrou e precisa ser revertido ou corrigido.
Essa diferença importa porque muita empresa de porte médio trata todo chamado igual, do “esqueci a senha” ao “ERP parou para todo mundo”. O resultado é previsível: o incidente crítico espera na mesma fila do incidente trivial, e ninguém consegue dizer, com dado, se o suporte está funcionando bem ou mal.
A matriz de severidade: SEV1 a SEV4
O primeiro passo de qualquer gestão de incidentes de TI é a matriz de severidade. Ela converte “o sistema caiu” em um nível objetivo, com meta de resposta associada, para que a triagem não dependa do humor de quem atende o telefone naquele momento.
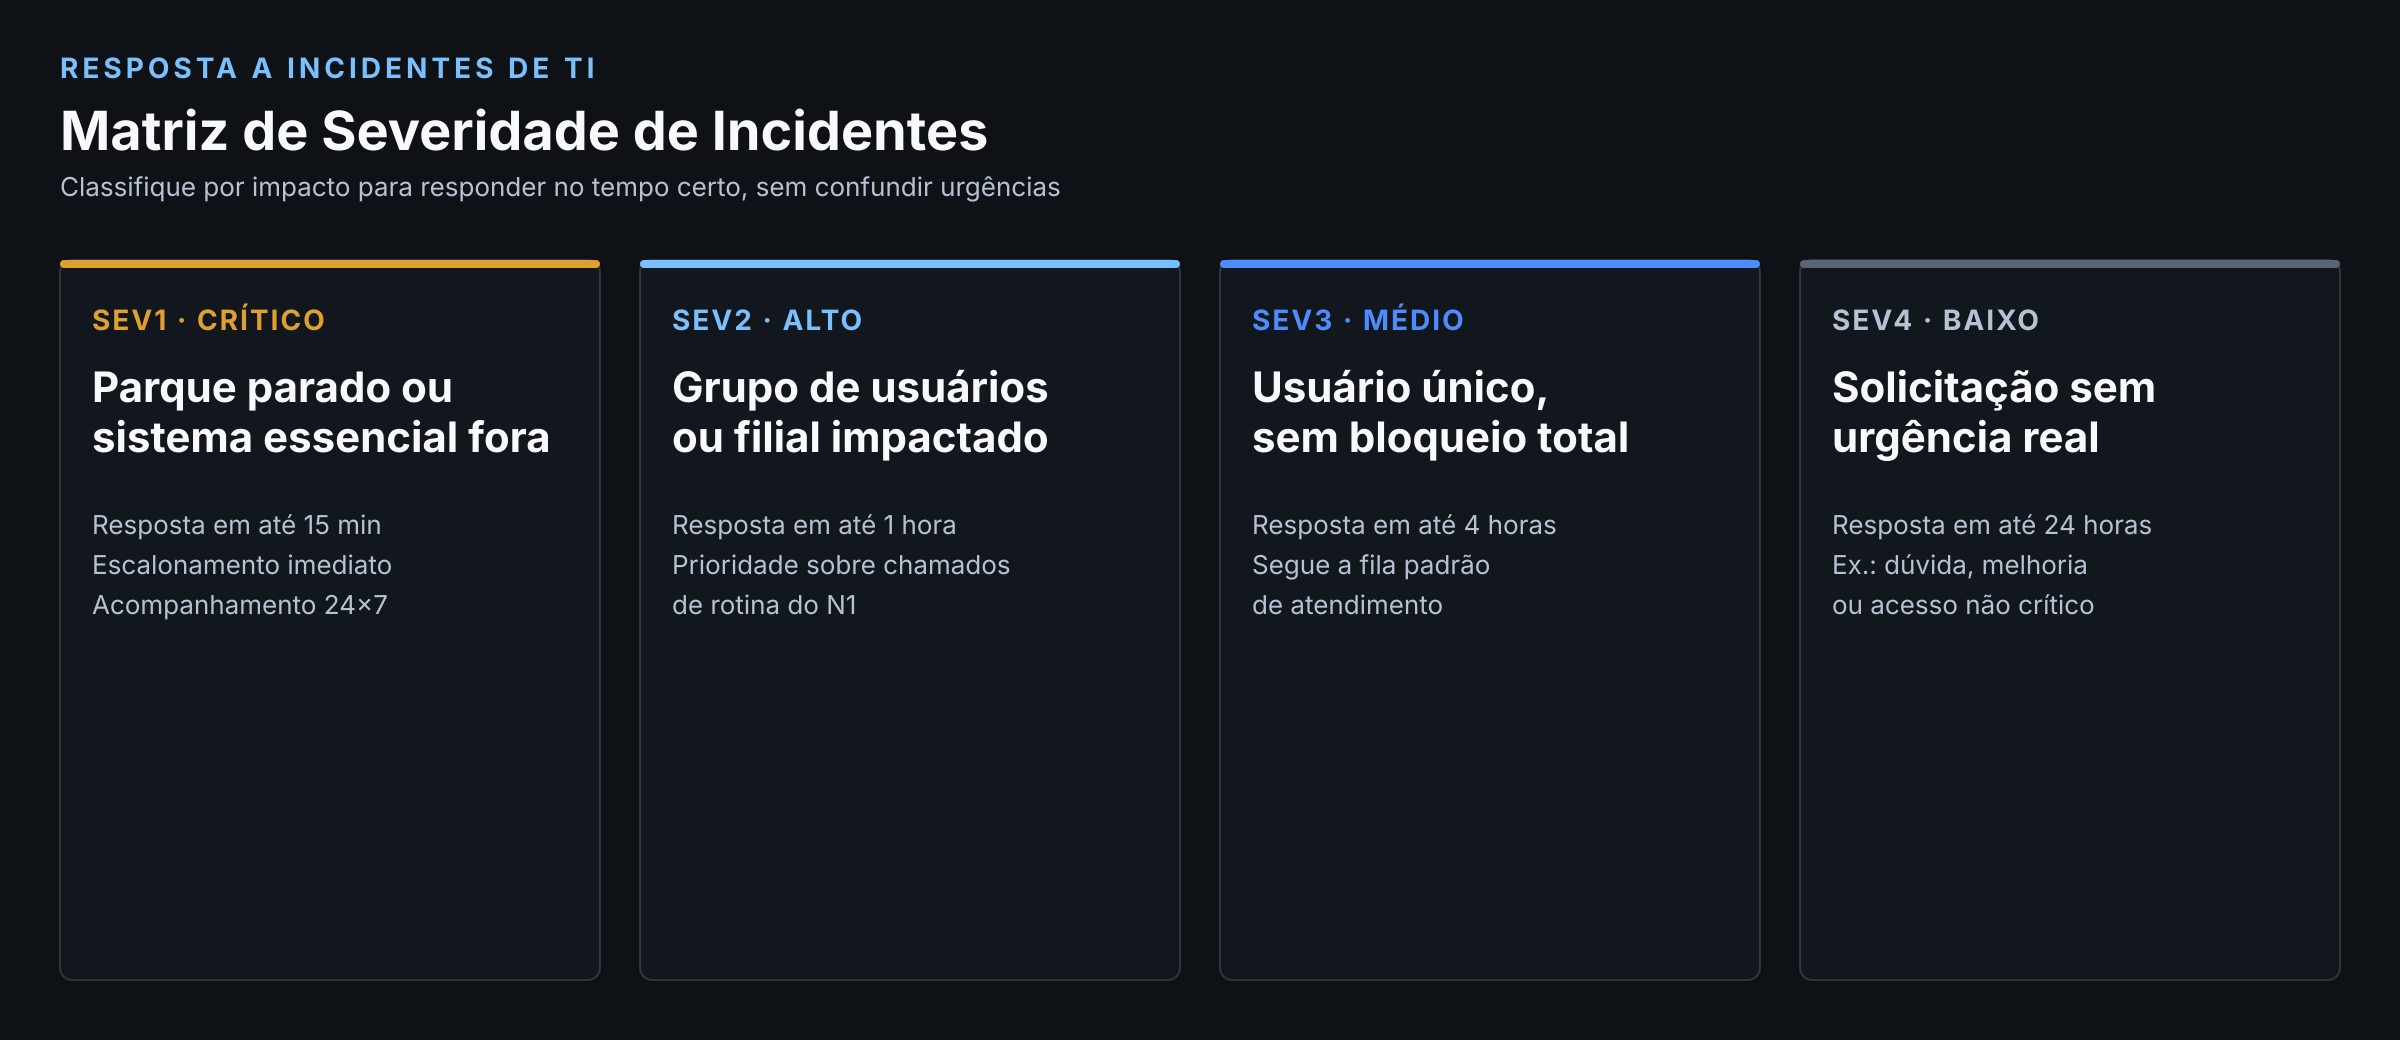
Na prática, quatro faixas cobrem a maioria dos cenários de uma empresa B2B:
- SEV1 (crítico): parque parado ou sistema essencial fora do ar, com resposta em até 15 minutos e escalonamento imediato.
- SEV2 (alto): um grupo de usuários ou uma filial impactada, com resposta em até 1 hora.
- SEV3 (médio): um único usuário afetado, sem bloqueio total da operação, resposta em até 4 horas.
- SEV4 (baixo): solicitação sem urgência real, como dúvida de uso ou pedido de acesso, resposta em até 24 horas.
A matriz só funciona se estiver documentada e visível para quem atende o primeiro contato. Isso se conecta diretamente aos níveis de suporte de TI (N1, N2 e N3): a severidade define para qual nível o incidente deveria ir, e com qual prioridade, evitando que um SEV1 fique esperando na fila padrão do N1.
As 5 etapas do ciclo de um incidente
Depois de classificado, o incidente percorre um ciclo com começo, meio e fim claros. Pular uma etapa, como fechar o chamado sem registrar a causa, é o motivo mais comum de o mesmo incidente voltar a acontecer semanas depois.
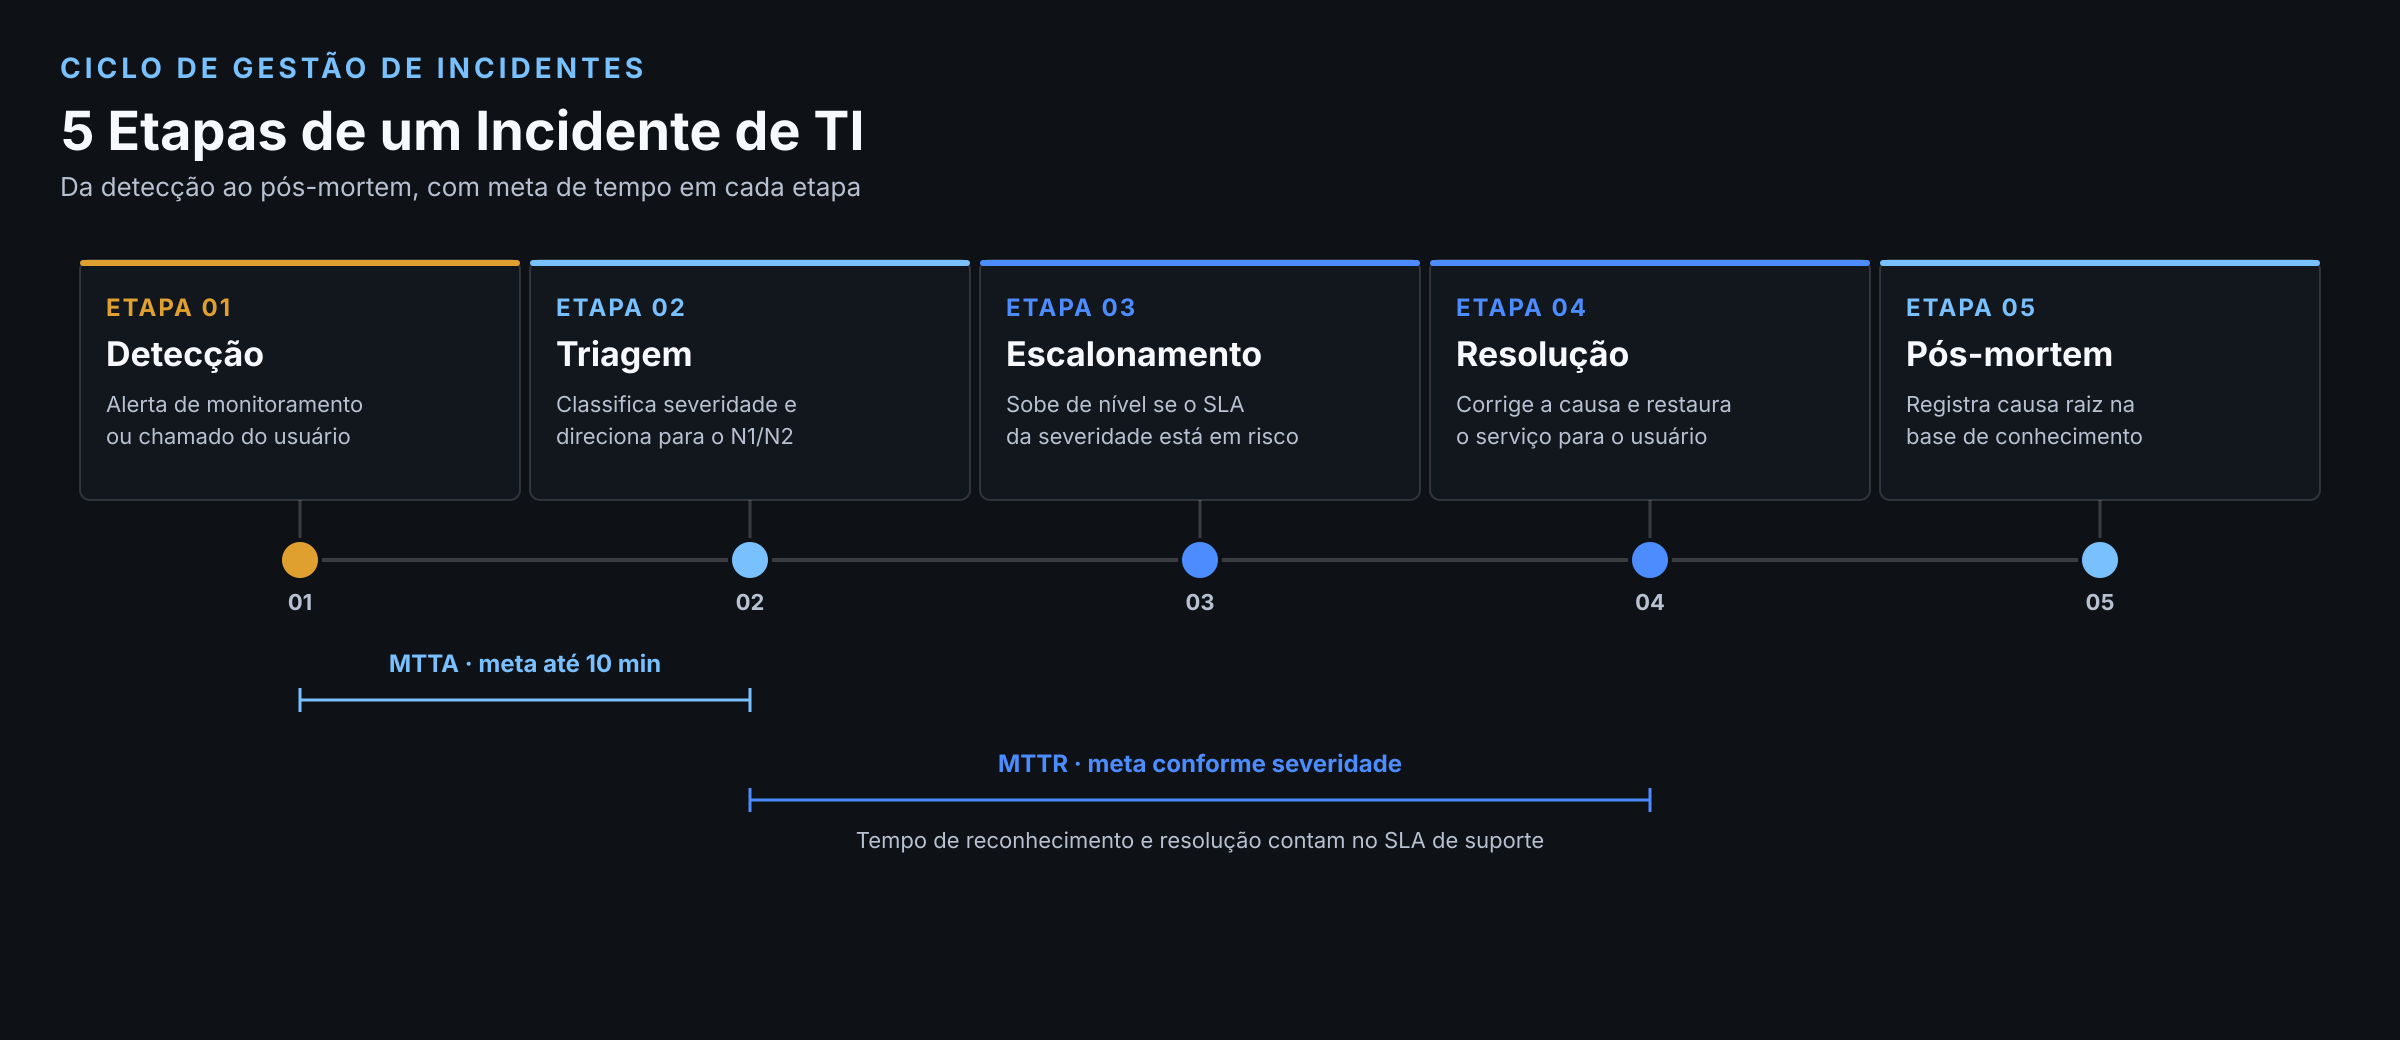
- Detecção: o alerta de monitoramento chega antes do usuário perceber, ou o próprio usuário abre o chamado.
- Triagem: a equipe classifica a severidade e direciona para o nível certo de suporte.
- Escalonamento: se o SLA daquela severidade está em risco, o incidente sobe de nível automaticamente.
- Resolução: a causa é corrigida e o serviço volta ao normal para quem foi afetado.
- Pós-mortem: a causa raiz e a solução aplicada são registradas, fechando o ciclo.
MTTA e MTTR: as duas métricas que importam
Gestão de incidentes de TI sem métrica é só uma lista de chamados fechados. Duas siglas resumem se o processo está funcionando: MTTA (tempo médio até alguém reconhecer o incidente) e MTTR (tempo médio até ele ser resolvido). Uma empresa pode ter um MTTA excelente, com resposta em minutos, e ainda assim um MTTR ruim, se a resolução depender de uma peça de reposição ou de um fornecedor externo que demora a responder.
Essas duas métricas também alimentam o SLA de suporte contratado: um SLA só é cumprido de verdade quando o tempo de reconhecimento e o tempo de resolução de cada severidade são medidos separadamente, não misturados em uma média geral que esconde o incidente crítico que estourou o prazo.
Escalonamento: quando subir de nível
Escalonamento não é admitir que o N1 falhou. É a regra que impede que um SEV1 continue preso na fila por falta de autonomia de quem atendeu primeiro. O gatilho mais simples é o próprio relógio do SLA: se metade do tempo de resposta da severidade já passou sem avanço, o incidente sobe automaticamente para o N2 ou N3, sem precisar que alguém perceba manualmente o atraso.
Esse mesmo princípio de escalonamento por tempo decorrido é o que estrutura um plano de recuperação de desastres de TI: incidentes SEV1 que não se resolvem dentro da janela esperada deixam de ser um problema de suporte e passam a acionar o plano de continuidade, com outro grupo de pessoas e outra prioridade.
Pós-mortem: o incidente que vira conhecimento
A etapa que mais empresa pula é também a mais barata: registrar o que aconteceu e como foi resolvido. Sem isso, o mesmo incidente volta a acontecer meses depois, e o técnico que resolveu da primeira vez pode nem estar mais na empresa. Alimentar a base de conhecimento de TI com a causa raiz e a solução aplicada é o que transforma cada incidente em um atalho para o próximo, em vez de um problema que se repete do zero.
Como a Note B2B apoia a gestão de incidentes de TI
A Note B2B estrutura esse processo completo para empresas que não têm um time de TI dedicado a montar matriz de severidade, SLA por nível e rotina de pós-mortem: do notebook corporativo ao suporte que reconhece, escala e resolve o incidente dentro do prazo combinado, com o histórico registrado para não repetir o mesmo problema duas vezes.
Quer estruturar a gestão de incidentes de TI da sua empresa com um parceiro que já opera isso no dia a dia? Fale com a Note B2B pelo WhatsApp: +55 11 91779-6473.
PRÓXIMO PASSO